人工智能技术的爆发式增长正在重塑全球计算基础设施的格局。从大型语言模型的训练到实时推理应用,AI工作负载对算力的需求呈指数级上升。作为算力的物理载体,AI服务器尤其是搭载高性能GPU的加速服务器,其功率密度已远远超出传统风冷系统的处理能力上限。NVIDIA H100、B200等旗舰芯片的单卡功耗突破700W乃至1000W,整机柜功率动辄达到40kW甚至100kW。在这种极端热负荷下,传统风冷不仅显得力不从心,更成为制约算力释放、推高运营成本的瓶颈。液冷技术凭借其卓越的传热效率和节能潜力,已从“可选方案”转变为AI数据中心的“必选项”。
风冷在AI场景下的物理极限
传统风冷依赖空气作为冷却介质,但空气的物理性质决定了其散热能力的天花板。空气的比热容仅为水的四分之一,导热系数更是只有水的二十分之一左右。这意味着要带走相同的热量,风冷系统需要巨大的风量和高转速风扇。
风冷面临的三大困境
- 能耗激增:为了维持芯片温度,服务器风扇功耗可占整机功耗的20%-30%。在AI高负载运行时,风扇全速运转产生的噪音和能耗令人咋舌,严重侵蚀了用于计算的能源预算。
- 热点难以消除:AI芯片内部存在明显的热点分布,风冷气流难以均匀覆盖所有区域,导致局部温度过高触发降频保护(Throttling),直接降低算力输出效率。
- 空间利用率低:受限于散热能力,风冷机房单机柜功率通常限制在10-15kW。为了部署同等规模的AI算力,需要更多的机柜和更大的机房面积,增加了土地和建设成本。
| 性能指标 | 传统风冷 | 液冷技术 | 对AI业务的影响 |
|---|---|---|---|
| 单机柜功率密度 | 10-15 kW | 40-100+ kW | 液冷大幅节省空间,提升单位面积算力 |
| PUE值 | 1.5 – 1.8 | 1.1 – 1.2 | 液冷显著降低电费,符合绿色合规要求 |
| 芯片结温控制 | 波动大,易触发热节流 | 稳定低温,确保持续满频 | 液冷保障AI训练任务不中断,提升效率 |
| 噪音水平 | 极高(>80 dB) | 极低(<45 dB) | 液冷改善工作环境,减少振动故障 |
液冷如何赋能AI算力
液冷技术通过直接接触热源或浸泡电子元件,从根本上解决了高密度散热难题,为AI服务器带来了多重核心价值。
1. 解锁极致算力,拒绝降频
AI训练任务往往持续数周甚至数月,任何因过热导致的降频都会延长训练周期,增加时间成本。液冷系统能将芯片温度控制在极低且稳定的水平,确保GPU始终运行在Boost频率下,最大化算力利用率。对于大规模集群而言,这种稳定性的提升意味着整体训练效率的显著优化。
2. 大幅提升能效,降低TCO
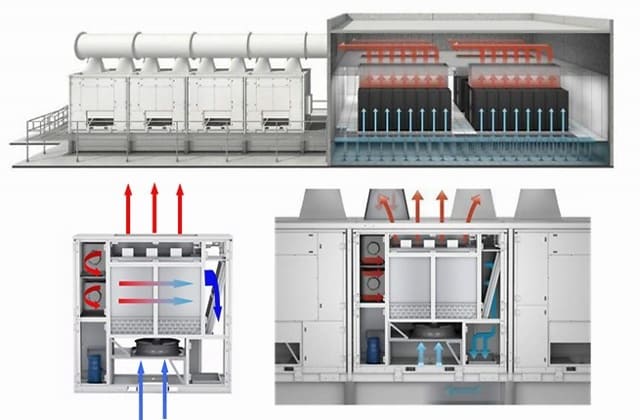
虽然液冷系统的初装成本略高于风冷,但其全生命周期成本(TCO)更具优势。一方面,去除了高功耗风扇,降低了服务器自身能耗;另一方面,液冷允许使用更高温度的冷却水(如25-30℃),极大延长了自然冷却(Free Cooling)的使用时长,减少了冷水机组压缩机的运行时间。据统计,液冷数据中心可比传统风冷节能30%-50%,在电价高昂的地区,这一节省尤为可观。
3. 提高部署密度,节约土地资源
液冷使得单机柜功率密度提升3-5倍成为可能。这意味着在相同的机房面积内,可以部署更多的高性能AI服务器。对于一线城市土地资源紧张的数据中心而言,这不仅是空间的节省,更是业务扩展能力的飞跃。
主流液冷技术在AI服务器中的应用
目前,应用于AI服务器的液冷技术主要有冷板式(Direct-to-Chip)和浸没式(Immersion)两种路径。
冷板式液冷:主流选择
冷板式液冷通过在CPU和GPU表面安装微通道冷板,直接带走核心热量。其优势在于技术成熟、改造难度相对较低、兼容现有服务器架构。目前,绝大多数主流AI服务器厂商均提供冷板液冷版本,适合大规模快速部署。
浸没式液冷:未来趋势
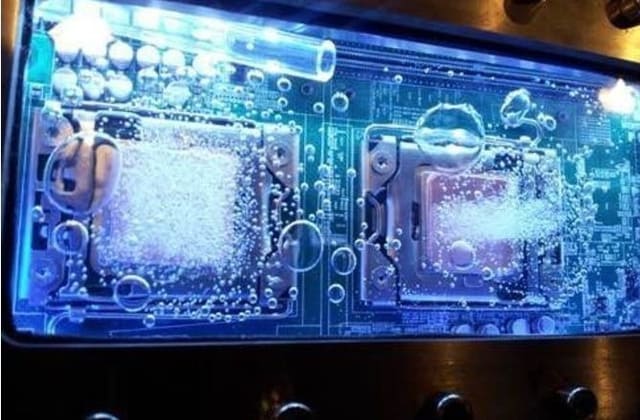
浸没式液冷将整台服务器浸泡在绝缘冷却液中,散热无死角,能效更高。虽然初期投入和维护复杂度较高,但对于追求极致PUE和超高密度的超算中心或专属AI集群,浸没式液冷代表了未来的发展方向。
总结
AI服务器对液冷的需求并非锦上添花,而是生存必需。面对日益攀升的功耗密度和严苛的能效指标,液冷技术以其高效的散热能力、显著的节能效果和紧凑的部署优势,成为构建新一代智算中心的基础设施基石。拥抱液冷,即是拥抱更高效、更绿色、更具竞争力的AI未来。
德恺液冷检测专注于AI服务器液冷系统的全方位质量验证,提供冷板热性能测试、浸没式兼容性评估、系统泄漏检测及能效优化咨询服务。我们助力客户打造稳定高效的智算底座,确保每一瓦电力都转化为有效算力。欢迎联系专业工程师获取详细检测服务咨询。